
Cuando una API debe devolver miles de registros, enviarlos todos en una sola respuesta suele ser poco práctico. La paginación divide el resultado en bloques más manejables, pero elegir cómo recorrerlos afecta al rendimiento, la navegación y la consistencia de los datos.
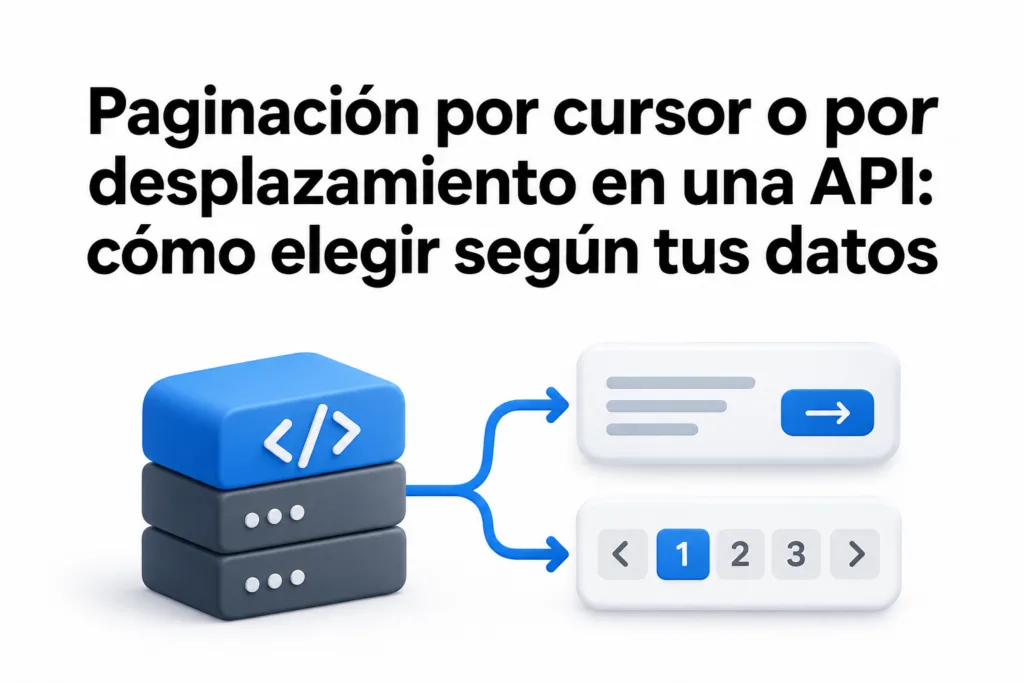
Las dos alternativas habituales son la paginación por cursor y la paginación por desplazamiento, también conocida como offset. Ninguna es mejor en todos los casos: la elección depende del tamaño del conjunto, de la frecuencia con que cambia y de cómo necesitan navegar los clientes.
En esta guía verás cómo funciona cada enfoque, qué problemas puede presentar y qué criterios utilizar para diseñar una API adecuada a tus datos.
Qué es la paginación en una API
Paginar consiste en devolver una parte ordenada de un conjunto de resultados y ofrecer al cliente una forma de solicitar la siguiente. Por ejemplo, una aplicación puede mostrar veinte productos por petición en lugar de descargar el catálogo completo.
Un diseño de paginación suele responder a estas preguntas:
- ¿Cuántos elementos incluye cada respuesta?
- ¿Cómo solicita el cliente el siguiente bloque?
- ¿Es necesario conocer el número total de resultados?
- ¿Qué ocurre si se insertan, modifican o eliminan registros durante el recorrido?
La última pregunta es especialmente importante: una lista paginada no permanece necesariamente igual entre una petición y otra.
Cómo funciona la paginación por desplazamiento
La paginación por desplazamiento indica cuántos registros deben omitirse antes de devolver el siguiente bloque. Normalmente se combina con un límite de resultados.
Por ejemplo, GET /productos?limit=20&offset=40 solicita hasta veinte productos después de omitir los primeros cuarenta. Si el orden es estable, corresponde al tercer bloque de resultados.
En una base de datos relacional, esta idea suele expresarse con LIMIT y OFFSET. La API también puede aceptar un número de página y calcular internamente el desplazamiento: para la página 3 y un tamaño de 20, el offset es 40.
Ventajas del desplazamiento
Su principal atractivo es la sencillez. El cliente puede calcular la posición de cualquier página sin conocer las respuestas anteriores. Esto facilita interfaces con botones como «primera», «anterior», «siguiente» o acceso directo a una página concreta.
También resulta cómodo cuando el producto necesita mostrar un número total de registros o páginas. No obstante, calcular ese total puede requerir una consulta costosa; no es una ventaja gratuita de usar offset.
Limitaciones que debes considerar
Con desplazamientos grandes, la base de datos puede necesitar recorrer o descartar muchos registros antes de llegar al bloque solicitado. El coste real depende del motor, la consulta y los índices, por lo que conviene medirlo con datos representativos.
Además, los cambios entre peticiones pueden alterar las posiciones. Imagina una lista de publicaciones ordenada de la más reciente a la más antigua. Si aparece una publicación nueva después de consultar la primera página, un elemento que ya viste puede desplazarse a la segunda y repetirse. Una eliminación anterior a la posición consultada también puede provocar que se omita un elemento.
El desplazamiento suele ser razonable para conjuntos pequeños o moderados, relativamente estables, especialmente si saltar a una página concreta es una necesidad importante.
Cómo funciona la paginación por cursor
La paginación por cursor entrega al cliente una referencia a la posición desde la que debe continuar. En lugar de pedir «omite 40», la siguiente petición expresa, en esencia, «continúa después del último elemento recibido».
Por ejemplo, una respuesta podría incluir veinte publicaciones y un campo next_cursor. El cliente enviaría ese valor en una petición como GET /publicaciones?limit=20&cursor=VALOR.
El cursor puede representar los valores de ordenación del último registro devuelto. Si la lista se ordena por fecha de creación e identificador, ambos valores permiten localizar el punto de continuación. El cliente debería tratar el cursor como un valor opaco: conservarlo y reenviarlo sin depender de su estructura interna.
Ventajas del cursor
Con una consulta de tipo keyset y un índice adecuado, la base de datos puede buscar a partir de la última clave en vez de descartar un número creciente de filas. Esto suele hacer el recorrido más eficiente en conjuntos grandes, aunque el resultado depende de la consulta y del motor.
También reduce ciertos problemas causados por inserciones o eliminaciones antes de la posición actual. Si se añade una publicación más reciente mientras recorres publicaciones antiguas, esa inserción no desplaza el punto de continuación como ocurre con un offset.
Limitaciones que debes considerar
El cursor no permite saltar de forma natural a la página 50 sin conocer una posición de partida. La navegación hacia atrás también requiere diseño adicional, por ejemplo, un cursor anterior y una consulta con el orden apropiado.
Además, usar cursores no garantiza por sí solo una instantánea consistente. Si se modifican los campos de ordenación, un registro puede moverse durante el recorrido y aparecer dos veces o quedar sin ver. Las nuevas filas y las eliminaciones también pueden afectar al contenido observado, según su posición y las reglas de la consulta.
Por eso, el cursor suele encajar bien en feeds, historiales y listas extensas que se recorren de forma secuencial, pero no sustituye una estrategia de consistencia cuando se necesita procesar una versión exacta del conjunto.
Comparación: qué método elegir
Antes de decidir, revisa estas necesidades:
| Criterio | Desplazamiento | Cursor |
|---|---|---|
| Navegación directa | Permite calcular el acceso a una página | Normalmente exige conocer un cursor previo |
| Conjuntos grandes | Los offsets profundos pueden ser costosos | Una consulta keyset indexada puede escalar mejor |
| Datos cambiantes | Los cambios de posición pueden causar repeticiones u omisiones | Reduce algunos desplazamientos, pero no crea una instantánea |
| Implementación | Suele ser más sencilla | Requiere definir orden, cursor y condiciones de continuación |
| Total de resultados | Puede mostrarse, con el coste de calcularlo | También puede calcularse, pero no viene implícito |
Para un panel interno con pocos miles de registros y navegación por números de página, offset puede ser suficiente. Para un historial de eventos grande que el usuario recorre hacia atrás, un cursor suele ser una opción más apropiada. Son puntos de partida, no garantías: verifica el comportamiento con tus consultas y tus volúmenes.
Cómo diseñar una paginación por cursor fiable
Define un orden estable y único
El orden debe ser explícito. Ordenar solo por fecha no basta si varias filas comparten el mismo instante: la base de datos podría devolverlas en distinto orden entre peticiones.
Una solución habitual es ordenar por created_at DESC, id DESC, usando un identificador único como desempate. Si el último registro de la página tiene fecha F e identificador I, la siguiente consulta debe buscar registros con created_at < F o, cuando la fecha sea igual, con id < I.
El cursor debe conservar ambos valores con la precisión necesaria. También conviene definir cómo se tratan los valores nulos y procurar que los campos de ordenación no cambien durante el recorrido. Un índice compatible con los filtros y el orden puede ayudar, pero su diseño debe validarse con el plan de ejecución de la consulta.
Devuelve un cursor solo si hay más resultados
Una técnica es solicitar internamente un elemento más que el límite. Si el cliente pide 20 y la consulta encuentra 21, la API devuelve 20 y genera next_cursor a partir del último elemento entregado. El elemento adicional sirve para detectar que existe otra página; no debe usarse como punto de partida, porque se omitiría.
Si no hay más resultados, devuelve next_cursor como null o usa otra convención documentada. Así, el cliente sabe cuándo detenerse sin adivinar a partir del tamaño de la respuesta.
Vincula el cursor a la consulta
Un cursor obtenido con un filtro o un orden no debería reutilizarse silenciosamente con otros parámetros. Por ejemplo, continuar una búsqueda de productos activos con un cursor generado para productos archivados puede producir resultados inesperados.
Documenta qué filtros, orden y tamaño de página deben mantenerse. El servidor puede incluir información de contexto en el cursor y validarla al recibirlo. También debe rechazar los cursores malformados o incompatibles con un error claro.
Codificar un cursor no lo protege automáticamente: si contiene información sensible, evita exponerla o utiliza una protección adecuada. Una firma puede ayudar a detectar modificaciones, pero no oculta el contenido. La autorización debe comprobarse en cada petición, independientemente del cursor.
Buenas prácticas para ambos enfoques
Establece un tamaño de página predeterminado y un máximo para evitar respuestas excesivas. Valida que limit, offset y los demás parámetros tengan valores permitidos y devuelve errores comprensibles cuando no sea así.
Mantén también un orden explícito y determinista con offset; sin él, las páginas pueden variar incluso aunque los datos no cambien. Documenta la estructura de la respuesta, el significado de los parámetros y si el total de resultados está disponible o puede ser aproximado.
Por último, prueba con registros que compartan valores de ordenación, inserciones y eliminaciones entre páginas, conjuntos vacíos y solicitudes profundas. Si necesitas exportaciones completas o procesamiento sin omisiones, evalúa mecanismos específicos de instantánea o un proceso de exportación: ni offset ni cursor, por sí solos, garantizan esa propiedad.
Conclusión
La paginación por desplazamiento destaca por su simplicidad y por permitir saltos directos; la paginación por cursor favorece el recorrido secuencial de conjuntos grandes y cambiantes. La decisión depende de la navegación requerida, el coste de las consultas y la consistencia que espera el cliente.
Antes de implementar cualquiera de las dos, define el orden, prueba con datos representativos y documenta qué ocurre cuando los registros cambian. Esa revisión hará que la elección responda a tu API y no solo a una preferencia técnica.