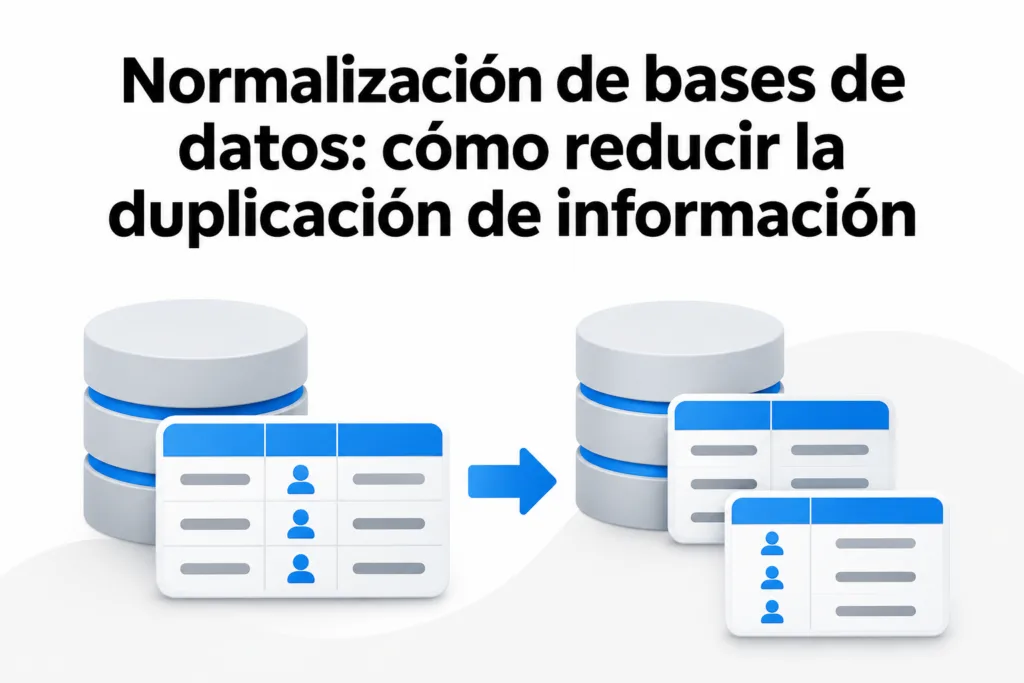

Cuando una base de datos guarda el mismo nombre, dirección o descripción en muchas filas, mantener la información coherente se vuelve más difícil. Un cambio que debería hacerse una sola vez puede requerir decenas de actualizaciones y, si alguna se olvida, aparecen datos contradictorios.
La normalización de bases de datos ayuda a organizar la información para reducir esa duplicación y evitar errores. En esta guía verás cómo funciona, qué problemas resuelve y cómo aplicar las tres primeras formas normales con un ejemplo práctico. También conocerás sus límites y las situaciones en las que conviene conservar cierta redundancia.
Qué es la normalización de bases de datos
La normalización es un proceso de diseño que organiza los datos en tablas relacionadas según sus dependencias. En términos sencillos, busca que cada hecho se almacene en el lugar que le corresponde y que las relaciones entre hechos se expresen mediante claves.
Por ejemplo, el nombre de un cliente pertenece a la información del cliente, mientras que la fecha de un pedido describe al pedido. Aunque ambos datos estén relacionados, no tienen por qué repetirse juntos en cada línea de compra.
Esto no significa que una base de datos normalizada no repita ningún valor. Las claves foráneas se repiten para conectar registros: varios pedidos pueden contener el mismo identificador de cliente. Esa repetición expresa una relación; no obliga a copiar el nombre y la dirección del cliente en cada pedido.
Claves y dependencias: dos conceptos básicos
Una clave primaria identifica de forma única cada fila de una tabla. Una clave foránea contiene valores que hacen referencia a una clave de otra tabla y permite establecer una relación entre ambas.
Una dependencia funcional existe cuando el valor de uno o varios campos determina el valor de otro. Por ejemplo, si cada identificador de cliente corresponde a un único cliente, cliente_id determina su nombre. Identificar estas dependencias ayuda a decidir dónde guardar cada atributo.
Qué problemas causa la duplicación
Imagina una tabla de pedidos que repite los datos del cliente y del producto en cada fila. Si un cliente realiza varios pedidos, su nombre y dirección aparecen varias veces. Esta estructura puede provocar tres tipos de anomalías:
- Actualización: al cambiar la dirección del cliente, hay que modificar todas las filas correspondientes. Si se omite alguna, quedan direcciones inconsistentes.
- Inserción: si los clientes solo se guardan en una tabla de pedidos, puede resultar difícil registrar un cliente que todavía no ha comprado.
- Eliminación: al borrar el último pedido de un cliente, también podrían perderse sus datos si no existen en otro lugar.
La normalización aborda estos problemas separando los hechos que tienen ciclos de vida diferentes. Un cliente puede existir sin pedidos, y un producto puede actualizarse sin modificar manualmente todas las líneas en las que aparece.
Las tres primeras formas normales
Las formas normales son reglas que ayudan a evaluar la estructura de las tablas. Las tres primeras suelen ser un punto de partida práctico; para aplicarlas correctamente hay que conocer las claves y las dependencias reales del negocio.
Primera forma normal: un valor por campo
Una tabla está en primera forma normal, o 1FN, cuando sus campos contienen valores individuales para el diseño elegido y no hay grupos repetidos de columnas o listas que deban manipularse como elementos independientes.
Por ejemplo, guardar Teclado, Ratón en un campo de productos complica consultar cantidades, precios o existencias de cada artículo. Una alternativa es representar cada producto de un pedido en una fila distinta.
La idea de «valor individual» depende del uso: una dirección completa puede ser apropiada en un solo campo si siempre se trata como texto, pero conviene dividirla si se necesita buscar o validar por ciudad y código postal.
Segunda forma normal: depender de la clave completa
Una tabla cumple la segunda forma normal, o 2FN, cuando está en 1FN y ningún atributo que no forme parte de una clave candidata depende solo de una parte de una clave candidata compuesta. Una clave candidata es un conjunto mínimo de campos capaz de identificar una fila; la clave primaria es una de las candidatas elegida para identificarla.
Supongamos que una línea se identifica mediante la pareja pedido_id y producto_id, y que cada producto aparece como máximo una vez por pedido. La cantidad corresponde a esa combinación. En cambio, la fecha del pedido depende solo de pedido_id, y el nombre del producto depende solo de producto_id.
Para evitar esas dependencias parciales, la fecha debe ir en una tabla de pedidos y el nombre en una tabla de productos. La tabla de líneas conserva los datos propios de la combinación, como la cantidad.
Tercera forma normal: evitar dependencias indirectas
En términos prácticos, una tabla en tercera forma normal, o 3FN, está en 2FN y evita que un atributo no clave dependa de otro atributo no clave, en lugar de depender directamente de una clave.
Por ejemplo, si una tabla de pedidos contiene pedido_id, cliente_id y nombre_cliente, el identificador del pedido determina qué cliente hizo la compra, pero el nombre depende de cliente_id. Guardar el nombre en la tabla de clientes evita repetirlo en cada pedido.
Esta explicación es una guía útil, aunque la definición formal de 3FN considera todas las claves candidatas y admite ciertos casos especiales. En diseños complejos, conviene analizar las dependencias antes de aplicar una regla simplificada.
Ejemplo práctico: de una tabla única a varias relacionadas
Supongamos una tienda que registra pedidos con las siguientes columnas en una sola tabla:
pedido_id, fecha, cliente_id, nombre_cliente, direccion_cliente, producto_id, nombre_producto, cantidad y precio_unitario.
Cada fila representa un producto incluido en un pedido. En este ejemplo, un producto aparece como máximo una vez por pedido, por lo que la combinación de pedido_id y producto_id identifica una línea. Si el mismo cliente hace varios pedidos o un pedido incluye varios productos, algunos datos se repiten.
Una posible reorganización es la siguiente:
- Clientes:
cliente_id,nombre_cliente,direccion_cliente. - Pedidos:
pedido_id,fecha,cliente_id. - Productos:
producto_id,nombre_producto. - Líneas de pedido:
pedido_id,producto_id,cantidad,precio_unitario.
cliente_id en Pedidos es una clave foránea que apunta a Clientes. En Líneas de pedido, pedido_id y producto_id apuntan a Pedidos y Productos, respectivamente. Su combinación puede ser la clave primaria bajo la regla indicada de una línea por producto y pedido.
Si el negocio permite varias líneas para el mismo producto en un pedido, haría falta otro identificador de línea o una clave distinta. La estructura debe reflejar las reglas reales, no una suposición que los datos puedan incumplir.
Qué ocurre con el precio histórico
El precio_unitario de la línea representa el precio acordado en ese pedido. Aunque el producto tenga un precio actual en otra tabla, conservar el precio de compra en la línea permite mantener el historial cuando el precio vigente cambie.
No es una copia accidental del mismo hecho: el precio actual del producto y el precio aplicado a una venta son datos diferentes. Lo mismo puede ocurrir con una dirección de entrega registrada para un pedido, aunque después cambie la dirección habitual del cliente.
Cómo normalizar una base de datos paso a paso
- Describe las entidades y sus reglas. Identifica qué representan los datos: clientes, pedidos, productos u otros conceptos. Pregunta, por ejemplo, si un pedido puede contener varias líneas del mismo producto.
- Define claves candidatas. Determina qué campos identifican cada registro de manera única. No supongas que un nombre o una dirección de correo son únicos sin una regla que lo garantice.
- Detecta grupos repetidos y dependencias. Busca listas dentro de campos, columnas duplicadas y atributos que dependan de solo una parte de una clave compuesta o de otro atributo no clave.
- Separa los hechos en tablas. Agrupa los atributos que describen la misma entidad y crea tablas intermedias cuando una relación necesite datos propios, como la cantidad de una línea de pedido.
- Conecta las tablas y aplica restricciones. Declara claves primarias, claves foráneas y restricciones de unicidad o valores obligatorios cuando correspondan. Las reglas deben proteger la coherencia también al escribir datos.
- Comprueba consultas y operaciones. Prueba altas, cambios y eliminaciones. Verifica que puedes reconstruir la información necesaria mediante relaciones y que no se pierden hechos relevantes.
Si trabajas con una base existente, prepara una migración que incluya limpieza de duplicados, copia de seguridad y comprobaciones de integridad. Normalizar el esquema sin resolver previamente los registros contradictorios puede trasladar el problema en lugar de eliminarlo.
Normalización, consultas y rendimiento
Separar datos en varias tablas suele requerir consultas con combinaciones, conocidas como joins, para reunir información. Esto no implica por sí solo que el sistema vaya a ser lento: el resultado depende del volumen de datos, los índices, las consultas y el motor utilizado.
Empieza por un diseño coherente y mide las consultas importantes antes de introducir cambios por rendimiento. Los índices adecuados pueden ayudar, aunque también ocupan espacio y añaden trabajo a las operaciones de escritura.
La desnormalización consiste en introducir redundancia de forma deliberada, por ejemplo, para facilitar una consulta frecuente. Puede ser útil, pero exige decidir cómo se mantendrán sincronizadas las copias y qué nivel de desfase es aceptable. No debe confundirse con guardar datos históricos diferentes, como el precio aplicado a una venta.
Errores frecuentes que conviene evitar
- Dividir tablas sin entender el negocio. Una separación arbitraria puede complicar las consultas o perder reglas importantes.
- Eliminar datos históricos necesarios. Una dirección de entrega o un precio pactado pueden tener que conservarse aunque cambien los datos actuales.
- Confiar solo en la aplicación. Si el motor lo permite, las restricciones en la base de datos ayudan a impedir referencias inexistentes y duplicados no deseados.
- Usar una clave inadecuada. Una clave que puede cambiar o que no es realmente única dificulta mantener las relaciones.
- Optimizar sin medir. Añadir copias o combinaciones de tablas por intuición puede introducir complejidad sin resolver un problema real.
Conclusión
La normalización de bases de datos reduce la duplicación innecesaria al situar cada hecho donde corresponde y relacionar las tablas mediante claves. Las tres primeras formas normales ofrecen una guía para detectar listas, dependencias parciales y datos que dependen indirectamente de una clave.
El mejor siguiente paso es revisar una tabla que repita información en tu propio proyecto: identifica sus claves, anota las dependencias y comprueba si cada dato representa un hecho actual o un registro histórico. Esa revisión te ayudará a mejorar la coherencia sin perder información que el negocio necesita.