
Interbloqueos en bases de datos SQL: detección y solución
Una operación que suele terminar en milisegundos falla de pronto cuando varias personas trabajan al mismo tiempo. Al revisar el error, aparece una palabra inquietante: interbloqueo o deadlock. No significa necesariamente que la base de datos esté dañada, pero sí que dos o más transacciones han quedado esperando recursos que las otras mantienen bloqueados.
Detectar y resolver interbloqueos en bases de datos SQL requiere algo más que repetir la consulta fallida. Hay que reconstruir qué transacciones participaron, entender el orden en que solicitaron los bloqueos y corregir la causa sin comprometer la integridad de los datos. En esta guía verás cómo hacerlo y qué medidas ayudan a reducir su frecuencia.
Qué es un interbloqueo y cómo se produce
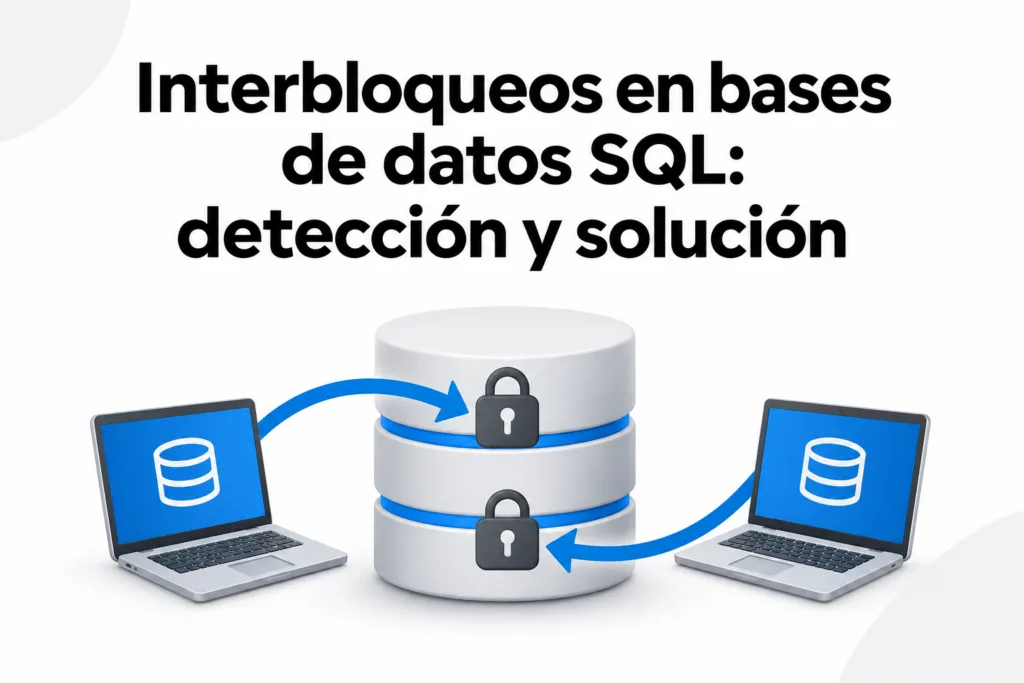
Los bloqueos son mecanismos de concurrencia que ayudan a proteger los datos cuando varias transacciones trabajan a la vez. Un interbloqueo aparece cuando se forma una espera circular: cada transacción necesita un recurso retenido por otra y ninguna puede avanzar por sí sola.
Imagina dos transacciones que actualizan dos cuentas:
- La transacción A bloquea la cuenta 1 y después solicita la cuenta 2.
- La transacción B bloquea la cuenta 2 y después solicita la cuenta 1.
- A espera a B y B espera a A. Se ha formado un ciclo.
Los motores suelen detectar este ciclo y elegir una transacción como víctima. Esa transacción se aborta para liberar recursos; la aplicación recibe un error y debe decidir cómo actuar. Los criterios de selección y la información disponible varían según el motor y su configuración.
Interbloqueo no es lo mismo que bloqueo prolongado
Una transacción puede esperar porque otra mantiene un bloqueo durante mucho tiempo sin que exista un ciclo. También puede agotarse un tiempo de espera antes de obtener un recurso. Ambos casos merecen investigación, pero no son necesariamente interbloqueos.
Esta diferencia importa: acortar una transacción puede aliviar las esperas, mientras que un ciclo recurrente puede requerir, además, cambiar el orden de acceso a los datos.
Cómo detectar interbloqueos en producción
El primer indicio suele aparecer en los registros de la aplicación: una operación falla bajo concurrencia, a veces de forma intermitente. Para confirmar la causa, correlaciona ese error con los datos que ofrece el motor de base de datos.
Recoge, siempre que sea posible:
- La hora del incidente y el motor afectado.
- El código de error, el estado SQL y la operación de negocio.
- Las sentencias implicadas y los identificadores de sesión o transacción.
- Los recursos solicitados y retenidos, como filas, claves de índice o tablas.
- La duración y el resultado de las transacciones involucradas.
Evita registrar contraseñas, datos personales u otros valores sensibles sin una necesidad justificada. Si capturas parámetros, aplica las políticas de seguridad y retención de tu organización.
Dónde buscar según el motor
Cada sistema proporciona herramientas diferentes. Estas son pistas de partida; los permisos, la configuración y el detalle disponible dependen de la instalación:
- PostgreSQL: revisa los registros del servidor para encontrar errores de interbloqueo. Para investigar esperas activas, las vistas
pg_stat_activityypg_locks, junto con la funciónpg_blocking_pids(), ayudan a relacionar sesiones y bloqueos. Un ciclo ya resuelto puede no seguir visible en esas vistas. - MySQL con InnoDB:
SHOW ENGINE INNODB STATUSpuede mostrar información del interbloqueo más reciente detectado por InnoDB. Para estudiar esperas activas, consulta las tablas de instrumentación disponibles en Performance Schema. Si necesitas conservar más incidentes, revisa las opciones de registro del motor. - SQL Server: los eventos extendidos permiten capturar gráficos de interbloqueo. La sesión
system_healthpuede contenerlos si está habilitada y los datos siguen disponibles. El gráfico muestra participantes, recursos y víctima; consulta también las vistas dinámicas de administración para investigar bloqueos activos.
Una vista instantánea es útil para una espera en curso, pero puede llegar demasiado tarde para un interbloqueo que el motor ya resolvió. Por eso conviene conservar registros o eventos y relacionarlos con los identificadores de la aplicación.
Reconstruye el ciclo antes de cambiar código
Un mensaje de error aislado no suele explicar por qué se produjo el problema. Busca el informe o gráfico del incidente y responde estas preguntas:
- ¿Qué transacciones participaron? Identifica las tareas de negocio, no solo las consultas individuales.
- ¿Qué recurso retenía cada una y cuál esperaba? Dibuja las dependencias hasta encontrar el ciclo.
- ¿En qué orden accedieron a esos recursos? Compara las rutas de código y las sentencias ejecutadas antes del error.
- ¿Cuánto duraban las transacciones? Busca cálculos, llamadas externas o esperas innecesarias mientras mantenían bloqueos.
- ¿Qué plan e índices se usaron? Una sentencia que examina más datos de los previstos puede ampliar el conjunto de recursos afectados.
Presta atención a los efectos indirectos. Los índices, las claves foráneas y los disparadores pueden implicar accesos adicionales que no son evidentes en la consulta principal. Los detalles de los bloqueos también dependen del motor, del plan de ejecución y del nivel de aislamiento.
Una vez identificadas las rutas implicadas, intenta reproducir el caso en un entorno de pruebas con datos y concurrencia representativos. No fuerces deliberadamente un interbloqueo en producción para diagnosticarlo.
Ejemplo: dos actualizaciones en orden inverso
Supongamos una tabla cuentas con una fila por identificador. En la primera sesión, ejecuta el inicio de transacción y actualiza la cuenta 1. En la segunda, inicia otra transacción y actualiza la cuenta 2. Ambas deben permanecer abiertas.
-- Sesión A
BEGIN;
UPDATE cuentas SET saldo = saldo - 10 WHERE id = 1;

-- Sesión B, en otra conexión
BEGIN;
UPDATE cuentas SET saldo = saldo - 10 WHERE id = 2;
Ahora, sin confirmar ninguna transacción, haz que A intente actualizar la cuenta 2 y que B intente actualizar la cuenta 1:
-- Sesión A: puede quedar esperando a B
UPDATE cuentas SET saldo = saldo + 10 WHERE id = 2;

-- Sesión B: puede cerrar el ciclo de espera
UPDATE cuentas SET saldo = saldo + 10 WHERE id = 1;
Con un motor transaccional que bloquee esas filas para la actualización, esta secuencia puede provocar un interbloqueo y un error en una de las sesiones. La sintaxis exacta de inicio de transacción y el comportamiento dependen del motor y de su configuración. Ejecuta cada bloque en la conexión indicada y usa un cliente que permita mantener ambas sesiones abiertas.
El ejemplo demuestra el orden inverso, no implementa una transferencia lista para producción. Tras observar el resultado, finaliza explícitamente las transacciones que sigan abiertas con ROLLBACK para dejar el entorno de pruebas limpio.
Estrategias para resolver y prevenir interbloqueos
Mantén un orden de acceso consistente
Si varias rutas necesitan modificar las mismas cuentas, establece una regla común: por ejemplo, acceder primero al identificador menor y después al mayor. Así, una transferencia de 1 a 2 y otra de 2 a 1 solicitarían los recursos en el mismo orden, aunque el signo de cada operación sea diferente.
Aplica la regla en todas las rutas relevantes, incluidos procesos en segundo plano. No presupongas que una cláusula ORDER BY garantiza por sí sola el orden de adquisición de bloqueos de cualquier consulta: comprueba el comportamiento del motor y el plan utilizado. Un orden consistente elimina esa clase de ciclo, pero no garantiza que desaparezcan todos los interbloqueos posibles.
Acorta las transacciones
Inicia la transacción cuando estés preparado para leer o modificar los datos necesarios y confírmala o reviértela cuanto antes. Evita mantenerla abierta mientras esperas una respuesta HTTP, una interacción del usuario o un cálculo que podría hacerse fuera de ella.
Reducir su duración limita el tiempo durante el cual se retienen bloqueos. Aun así, no dividas una operación que necesita ser atómica sin analizar antes las consecuencias para la consistencia de los datos.
Revisa consultas e índices
Examina los planes de ejecución y comprueba si las condiciones identifican adecuadamente las filas. Un índice apropiado puede reducir el trabajo y, según el motor y la consulta, los recursos bloqueados. Por ejemplo, una actualización que busca por id suele beneficiarse de que esa columna identifique las filas de forma eficiente.
No añadas índices a ciegas: también deben actualizarse cuando cambian los datos y pueden introducir costes o nuevas interacciones de bloqueo. Verifica el efecto con el plan y pruebas representativas.
Ajusta el aislamiento con criterio
El nivel de aislamiento determina qué garantías obtiene la transacción y afecta a su comportamiento concurrente. Reducirlo puede cambiar algunas esperas, pero también permitir resultados que la aplicación no tolera. Antes de modificarlo, identifica los invariantes del negocio y consulta la documentación del motor. No lo uses como remedio universal para los interbloqueos.
Cómo reintentar una transacción de forma segura
Incluso con un diseño cuidadoso puede quedar algún interbloqueo ocasional. La aplicación debe reconocer el error específico, limpiar o revertir la transacción según corresponda y reintentar la operación transaccional completa, no solo la última sentencia. La nueva tentativa debe comenzar con una transacción nueva y volver a leer los datos necesarios.
Los códigos dependen del controlador y del motor. Como ejemplos, PostgreSQL utiliza el estado SQL 40P01 para interbloqueos; MySQL suele informar el error 1213 para un interbloqueo de InnoDB; y SQL Server utiliza el error 1205 para la víctima. Comprueba cómo expone cada dato tu biblioteca y distingue estos casos de otros errores antes de reintentar.
Limita el número de intentos y añade una espera creciente con un componente aleatorio para evitar que las mismas operaciones choquen repetidamente. Si se agotan los intentos, registra el contexto y devuelve un fallo controlado.
También revisa la idempotencia: repetir la operación no debe duplicar efectos externos, como enviar un correo o cobrar dos veces. Mantén esos efectos fuera del reintento o utiliza mecanismos adecuados para coordinarlos. Un reintento es una red de seguridad, no un sustituto de corregir una causa recurrente.
Conclusión
Un interbloqueo es una espera circular entre transacciones, no cualquier consulta lenta. Para resolverlo, conserva la evidencia, identifica el ciclo y actúa sobre el orden de acceso, la duración de las transacciones y las consultas implicadas. Complementa los cambios con reintentos limitados y seguros.
Empieza por revisar el último incidente registrado y reconstruir las operaciones que participaron. Después reproduce el escenario en pruebas y comprueba que la corrección reduce el conflicto sin alterar las garantías que necesita tu aplicación.